Desenvolvendo pipelines de dados e modelos preditivos sem precisar mudar de linguagem
Um dos maiores mitos no desenvolvimento de aplicações modernas é a ideia de que o processamento de dados e o Machine Learning são exclusividades absolutas de outras linguagens. A resposta automática para esse tipo de demanda quase sempre envolve adotar uma nova stack.
Quem já trabalhou na manutenção de sistemas complexos provavelmente já passou por situações como:
- "A API principal é em PHP, mas o serviço de dados é em Python."
- "Precisamos gerenciar dois ambientes de deploy totalmente diferentes."
- "A comunicação entre os microsserviços adicionou latência."
- "O time não consegue dar manutenção no script externo de limpeza de dados."
Esses problemas consomem tempo e aumentam a complexidade do projeto.
É nesse cenário que o próprio ecossistema PHP surge como uma alternativa robusta para integrar inteligência analítica, mantendo a infraestrutura unificada.
O que é Análise de Dados no PHP?
O PHP é amplamente reconhecido por sua eficiência na web, mas a linguagem evoluiu muito. Graças às melhorias no consumo de memória, tipagem avançada e ao compilador JIT (Just-In-Time), o PHP hoje possui excelente capacidade para processar grandes volumes de informações.
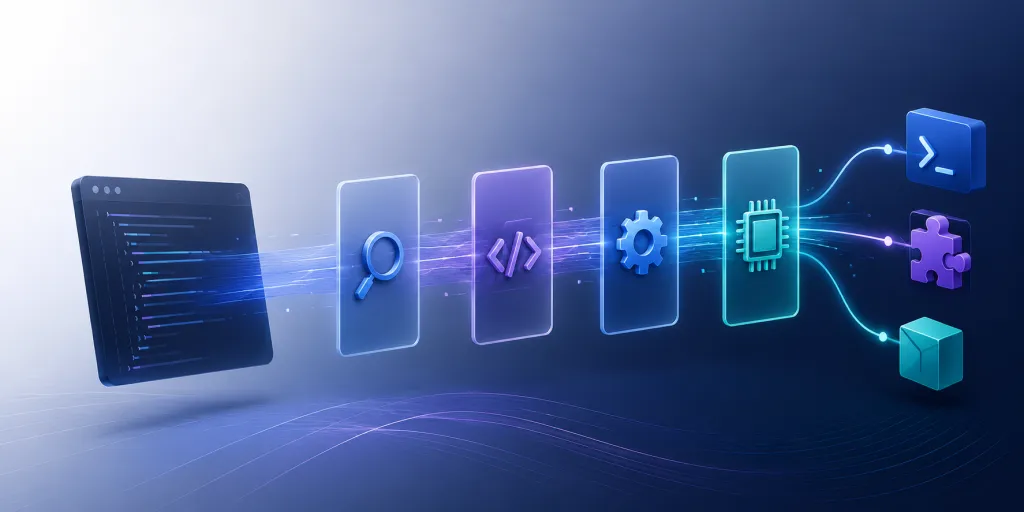
Ele permite criar um fluxo completo e profissional, incluindo:
- Extração, Transformação e Carga (ETL);
- Regressão, classificação e clusterização (Machine Learning);
- Estatísticas complexas e probabilidade;
- Processamento estruturado de bases massivas.
Na prática, sua aplicação passa a processar inteligência diretamente, sem a necessidade de APIs intermediárias externas.
Por que utilizar PHP no processamento de dados?
1. Uma única stack para todo o projeto
O maior benefício de centralizar a análise de dados no PHP é o ganho na manutenção.
Se o seu sistema local já roda em containers orquestrados com o DDEV, o seu processamento analítico vai rodar exatamente no mesmo ambiente. Sem atritos, sem ter que gerenciar versões cruzadas de pacotes e com a mesma facilidade de deploy que a sua equipe já domina.
2. Integração com bancos de dados modernos
Uma ótima arquitetura para dados em PHP é evitar estrangular a memória do servidor com os cálculos iniciais e delegar a carga para o banco.
Você pode realizar as agregações pesadas em um banco de dados escalável — como um PostgreSQL rodando via Supabase — e utilizar o PHP apenas como o grande maestro da operação. Ele busca os dados pré-processados, aplica a lógica de negócio final, cacheia o que for necessário e entrega o resultado final.
3. Ferramentas e pacotes consolidados
O ecossistema já construiu as pontes necessárias para o cálculo avançado:
Rubix ML
Uma biblioteca madura focada em aprendizado de máquina. Possui uma ótima documentação e permite que você treine e execute modelos preditivos de forma nativa no seu código PHP.
MathPHP
Um conjunto extenso de ferramentas matemáticas e estatísticas. Substitui de forma competente a necessidade de integrar rotinas estatísticas externas.
Boas práticas trabalhando com grandes volumes
Algumas recomendações de performance:
Utilize Generators
Um erro comum é carregar uma base inteira na memória, gerando travamentos (Allowed memory size exhausted). O uso de Generators (yield) permite que o PHP leia arquivos gigantescos uma linha de cada vez:
function processarCsv($arquivo) { $handle = fopen($arquivo, 'r'); while (($linha = fgetcsv($handle)) !== false) { yield $linha; } fclose($handle); }
Gerencie via Composer
Trate os pacotes de dados como qualquer outra dependência. A instalação é simples e direta:
composer require rubix/ml
O ecossistema fica versionado no seu composer.lock e garantido em todos os ambientes da equipe.
PHP vs. Linguagens tradicionais de dados
Se formos comparar a abordagem tradicional com o uso do PHP em aplicações web:
| Recurso | Ferramentas Tradicionais | Ecossistema PHP |
|---|---|---|
| Exploração Visual (Gráficos) | Excelente | Limitada |
| Ecossistema de Bibliotecas | Gigante | Focado e Eficiente |
| Integração em Aplicação PHP | Exige API Externa | Nativa e Direta |
| Complexidade de Servidor | Alta (Duas stacks) | Baixa (Stack Unificada) |
| Curva de Aprendizado | Alta | Baixíssima |
Conclusão
O PHP representa uma plataforma extremamente madura não apenas para a web clássica, mas para abraçar a engenharia de dados dentro das próprias aplicações corporativas.
Para desenvolvedores que mantêm portais robustos, ambientes institucionais complexos ou que trabalham no serviço público com sistemas que requerem modernização analítica, abraçar as ferramentas nativas do PHP traz um alívio gigante na infraestrutura.
Ao invés de gastar energia e recursos configurando conexões com serviços paralelos, você mantém seu fluxo de desenvolvimento focado, direto e pronto para extrair todo o valor dos seus dados.